引言
2026 年 AI 应用进入 Agent 落地爆发期,市面上 AI 工具数量快速膨胀,通用对话助手、代码智能体、垂直领域 AI 工具层出不穷。很多团队与个人选型时陷入一个误区:盲目追逐最新旗舰模型,忽略任务本身需求,最终出现算力成本过高、数据隐私无法保障、AI 输出结果不可靠等问题。
通用 AI 助手、代码智能体、链上分析 AI 三者代表 AI 能力的三个层级:通用助手擅长开放式信息处理与多模态内容生成;代码智能体具备多步骤自主规划、读写文件、调用终端、迭代调试代码的能力;链上分析 AI 属于高度垂直的专业 Agent,对接链上原始数据集,完成地址聚类、资金路径追踪、智能合约风险识别。三者能力边界差异巨大,不存在一款万能 AI 工具覆盖全部场景。
本文构建一套四维实战选型框架:任务自主性、推理成本、数据安全、输出准确率,结合 2026 年行业实测数据,分层拆解三类 AI 工具的选型逻辑,梳理各自优势、短板与适用场景,给出组合选型策略。
 152023b5d6b99113df4f7f0a0616869.webp
一、通用 AI 助手选型:多模态、长上下文与推理成本的权衡
通用 AI 助手是应用最广的基础工具,2026 年主流产品已经全面升级多模态能力,支持文本、图片、表格、音频、短视频输入,长上下文窗口普遍达到 100 万 Token 级别。但是不同产品底层模型、定价策略、隐私策略差异显著。
旗舰闭源通用助手如 GPT-5.6、Claude Opus 5,强项在于复杂逻辑推理、超长文档精读、多模态混合解析,适合法律文档审阅、深度行业研究、复杂图文混合分析等高难度任务。缺点是按量计费,大规模批量调用成本高,并且用户输入数据会上传至服务商云端,敏感数据场景存在隐私风险。轻量闭源模型如 Gemini 3.5 Flash,推理成本大幅降低,适合批量摘要、图片 OCR、简单信息提取等标准化任务,性价比优势明显。
开源通用模型如 Qwen3.8、DeepSeek V4,可以本地私有化部署,数据不出内网,适合企业内部敏感资料处理。但本地部署需要承担 GPU 算力成本,硬件投入、运维人力成本不可忽视,复杂推理能力弱于闭源旗舰模型。
通用 AI 助手选型核心判断标准:首先区分任务复杂度,简单标准化任务优先选择轻量模型降低成本;深度复杂推理任务选择旗舰闭源模型;涉及内部敏感文档、数据不可外传场景,优先私有化开源部署。同时需要评估长文本稳定性,很多模型标称百万上下文,但超长文档后半段信息丢失现象依然存在,选型时需要做针对性实测。
2026 年行业实测数据显示,单纯使用旗舰模型处理简单任务,综合推理成本会高出轻量化模型 5~10 倍,是 AI 工具选型最常见的成本浪费。通用助手定位是基础信息处理,无法自主执行多步骤工程任务,这也是它和代码智能体最核心的分界线。
二、代码智能体选型:从代码补全到自主软件工程能力评估
代码智能体(Coding Agent)是 2026 年开发者领域增长最快的工具品类,已经脱离早期单行代码补全,能够自主解析大型代码仓库、拆解需求、编写代码、运行测试、定位 BUG、提交 PR,完成端到端软件工程任务。行业采用 SWE-bench Verified 作为核心评测基准,该基准基于真实 GitHub 开源项目缺陷,用来衡量 Agent 修复真实工程问题的能力。2026 年 Q1 头部代码智能体 SWE-bench 得分突破 80%,达到可以独立处理中小型项目的水平。
当前主流代码智能体分为 IDE 内嵌型与终端独立型两类。Cursor、Windsurf 属于 IDE 原生智能体,在代码编辑环境内完成全流程开发,上手门槛低,适合日常开发迭代;Claude Code、Aider 属于终端 CLI 智能体,适合大型代码库、批量脚本处理、自动化工程任务,自主规划能力更强;GitHub Copilot 偏向轻量辅助补全,企业团队生态成熟,合规体系完善,适合中小团队日常开发辅助,但复杂多文件重构能力弱于专业代码 Agent。
选型代码智能体不能只看基准跑分,四个维度需要重点评估:第一,代码库上下文加载能力,能否完整理解上万行代码仓库的依赖关系;第二,沙箱执行环境,是否支持隔离环境运行代码,防止恶意代码或者错误脚本破坏本地环境;第三,模型调用成本,大型项目全仓库索引会消耗大量 Token;第四,团队合规能力,企业场景需要核查训练数据版权、代码输出知识产权归属。
代码智能体存在明显短板:面对底层系统架构重构、复杂安全漏洞挖掘任务,依然需要人工深度介入;Agent 容易出现幻觉,生成看似可运行但存在隐藏缺陷的代码,所有 AI 生成代码都必须人工复核、单元测试。代码智能体定位是提升开发效率,不能完全替代工程师。
三、链上分析 AI 选型:垂直数据接口、地址聚类与风险溯源能力
链上分析 AI 属于高度垂直的专业 AI Agent,也是 2026 年区块链数据分析领域的重要增量。和通用 AI、代码智能体不同,链上 AI 不是单纯的大模型对话,而是大模型与链上索引数据库、地址实体标签库、交易风险规则引擎深度结合,能够读取链上海量交易数据,自动完成钱包地址聚类、资金流向可视化、智能合约漏洞扫描、聪明钱行为识别、可疑交易风险打分。
主流产品分为两类:一类是面向机构的专业链上智能分析平台,例如 Chainalysis AI Agent、TRM Labs Orion,拥有海量地址实体标签库,重点用于交易风险筛查、资金溯源、AML 合规调查,支持跨多链地址关联分析,广泛被交易所、金融机构使用;另一类是面向研究者的轻量化链上 AI 工具,Arkham、Dune AI 助手,可以自然语言编写链上 SQL 查询、生成链上指标看板、追踪大户钱包资金异动,降低链上数据分析门槛。
链上分析 AI 选型的核心评估指标。第一,多链数据覆盖范围,是否覆盖 BSC、以太坊、Solana 等主流公链,数据同步延迟;第二,实体标签准确率,地址聚类错误会直接导致资金溯源结论失真;第三,自然语言转 SQL 能力,能否把复杂业务需求转化为链上查询语句;第四,风险模型准确率,区分正常大户交易与洗钱、诈骗资金地址;第五,API 调用额度与订阅成本,机构级数据接口费用较高。
链上 AI 存在显著局限性:链上数据本身存在匿名地址混转、合约代理转账等复杂场景,AI 自动分析结果只能作为线索参考,不能直接当作最终结论;AI 无法获取链下托管资金、线下协议信息,链下资产行为无法通过链上数据推断。同时需要注意,链上分析工具仅用于学术数据研究,不可用于虚拟货币交易炒作。
四、AI 工具组合选型实战框架与落地策略
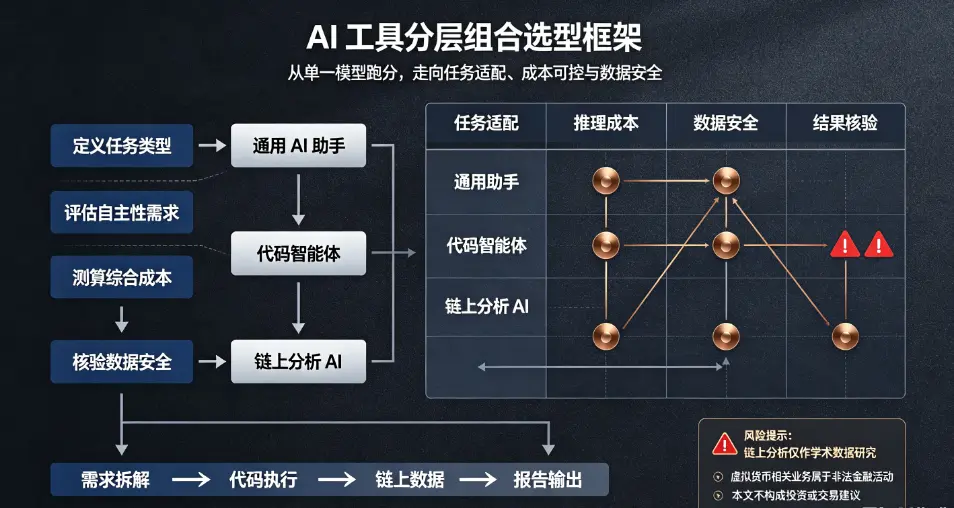
面对三类不同 AI 工具,2026 年的选型思路不再是单一工具全覆盖,而是搭建分层组合体系,遵循这套四步实战决策流程。第一步,定义任务类型:开放式信息检索、文档处理选择通用 AI 助手;代码开发、脚本自动化、工程任务选择代码智能体;链上数据查询、地址资金溯源、合约风险分析选择链上 AI。第二步,评估任务自主性需求:简单一次性问答使用通用对话模型;多步骤、需要读写文件、执行命令的工程任务选择 Agent 类工具。第三步,成本测算:预估月 Token 调用量、API 订阅费用、本地算力成本,避免盲目选用旗舰模型造成预算浪费。第四步,数据安全核验:敏感内部数据禁止使用公有云 API,优先私有化部署方案。
三类工具可以互相协同。通用 AI 助手负责业务需求拆解、报告撰写;代码智能体编写数据抓取、数据清洗脚本;链上 AI 负责拉取、解析链上原始数据,三者联动形成完整数据分析链路。
同时必须理性看待 AI 工具共性风险:所有 AI 都存在输出幻觉,越是专业垂直场景,越需要人工核验关键结论;Agent 在长链路任务中容易出现逻辑漂移,复杂任务需要拆分为小任务分步执行;批量 API 调用要做好限流、日志留存,控制整体成本。
2026 年 AI 工具迭代速度持续加快,Agent 自主性持续提升,但工具始终是辅助手段。选型的本质不是选择最强的模型,而是选择匹配任务需求、成本可控、风险可管控的工具组合。随着 Agent 生态持续完善,未来 AI 工具选型会更加注重任务适配、数据安全与综合 TCO 总成本,单纯追求模型跑分的选型思路会逐步被淘汰。
来源:
互联网
本文观点不代表区块经立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表